5. Data Guard – Datenschutz in Aktion
5.1 Was ist der Data Guard?
Der Data Guard ist die zentrale Datenschutz- und Sicherheitskomponente von GovAI. Er prüft alle Eingaben auf personenbezogene und sensible Daten, bevor diese an ein externes KI-Modell gesendet werden – vollautomatisch und transparent.
Kernprinzip: Externe KI-Modelle erhalten zu keinem Zeitpunkt Zugriff auf Originaldaten. Die Rückführung pseudonymisierter Daten auf die Originale erfolgt ausschließlich innerhalb der GovAI-Plattform.
Die De-Identifizierung im Data Guard ist technisch als Pseudonymisierung einzuordnen (DSGVO Art. 4 Nr. 5). Ein Re-Identifizierungsschlüssel verbleibt in der Plattform. Pseudonymisierte Daten gelten nach DSGVO weiterhin als personenbezogen. Der Data Guard reduziert das Risiko erheblich, ersetzt aber keine Rechtsgrundlage für die Datenübermittlung.
5.2 Der Verarbeitungspfad (End-to-End)
Nutzereingabe
      ↓
[1] PII-Erkennung (SLM + Regex-Regeln)
      ↓
[2] Pseudonymisierung: "Max Mustermann" → "[gYkPXYLm8g3NwI]"
      ↓
[3] Externes KI-Modell erhält nur pseudonymisierte Anfrage
      ↓
[4] KI-Antwort enthält Platzhalter statt Originaldaten
      ↓
[5] Interne Re-Kontextualisierung: "[gYkPXYLm8g3NwI]" → "Max Mustermann"
      ↓
Nutzer sieht Antwort mit Originaldaten
Details zum Prozess:
- Analyse: Jede Texteingabe (inkl. OCR-Text aus Dokumenten/Bildern) wird durch das PII-Erkennungsmodul analysiert.
- Klassifizierung: Erkannte sensible Daten werden mit ihrem PII-Typ benannt.
- Pseudonymisierung: Erkannte Daten werden durch strukturierte Platzhalter ersetzt (z. B.
{{redacted:UUID}}). Das Mapping Platzhalter ↔ Originalwert verbleibt ausschließlich in der Plattform. - Übermittlung: Nur pseudonymisierte Inhalte verlassen GovAI in Richtung externer Modelle.
- Re-Kontextualisierung: Die Modellantwort mit Platzhaltern wird intern zurückübersetzt, bevor sie dem Nutzer angezeigt wird.
Innerhalb eines Chats wird dasselbe PII-Vorkommen stets durch denselben Platzhalter ersetzt. Das Modell sieht den gesamten Chatverlauf nur in pseudonymisierter Form. GovAI hält intern sowohl die pseudonymisierten Texte als auch das vollständige Redact-Mapping für den gesamten Verlauf vor.
5.3 Erkannte PII-Typen (Mindestumfang)
Der Data Guard erkennt mindestens folgende Datenkategorien automatisch:
| PII-Typ | Beispiele |
|---|---|
| Namen | Vor- und Nachnamen, Doppelnamen, Namensvarianten |
| Telefonnummern | National und international, mit/ohne Vorwahl, mit Leerzeichen/Bindestrichen |
| E-Mail-Adressen | Alle gängigen Formate (lokaler Teil + Domain, Subdomains, verschiedene TLDs) |
| IP-Adressen | IPv4, perspektivisch IPv6 |
| Kreditkartennummern | VISA, MasterCard und weitere (typische Längen und Formate) |
Erkennungsmodalitäten:
| Modalität | Beschreibung |
|---|---|
| Chat-Text | Direkte Texteingaben und Konversationsverläufe |
| Freitextfelder | Eingaben in Assistenten und Werkzeugen |
| Dokumente | PDF, DOCX, PPTX, XLSX (max. 10 MB) |
| Bilder mit Text (OCR) | JPG, JPEG, PNG (max. 10 MB) – Bildinhalte selbst werden nie übertragen |
Mehrsprachigkeit: Die PII-Erkennung funktioniert mehrsprachig. Sprachunabhängige Muster (E-Mail, Telefon, IP-Adressen) werden unabhängig von der Sprache erkannt. Auch Personennamen in nicht-deutschsprachigen Texten werden erkannt.
Erweiterbarkeit: Über Regex-Regeln können organisationsspezifische Muster ergänzt werden.
5.4 Eigene Erkennungsmuster (Regex-Regeln)
Administratoren können zusätzliche Erkennungsmuster für organisationsspezifische sensible Daten konfigurieren:
Verwaltung: Einstellungen → Erweiterungen → Regex-Regeln
Typische Anwendungsfälle:
- Aktenzeichen (z. B.
AZ-\d{4}/\d{4}) - Personalnummern (z. B.
P\d{6}) - Interne Klassifizierungskennzeichnungen (z. B.
VS-NfD,Vertraulich) - Organisationsspezifische IDs
Regex-Treffer werden wie Standard-PII behandelt: Pseudonymisieren / Zulassen / Verwerfen.
Eine fehlerhafte Regex-Regel (z. B. unvollständige Klammer) führt nicht zum Ausfall der gesamten PII-Pipeline. Die übrigen Regeln bleiben wirksam. Testen Sie neue Regeln vor dem Produktiveinsatz.
5.5 Die drei Handlungsoptionen
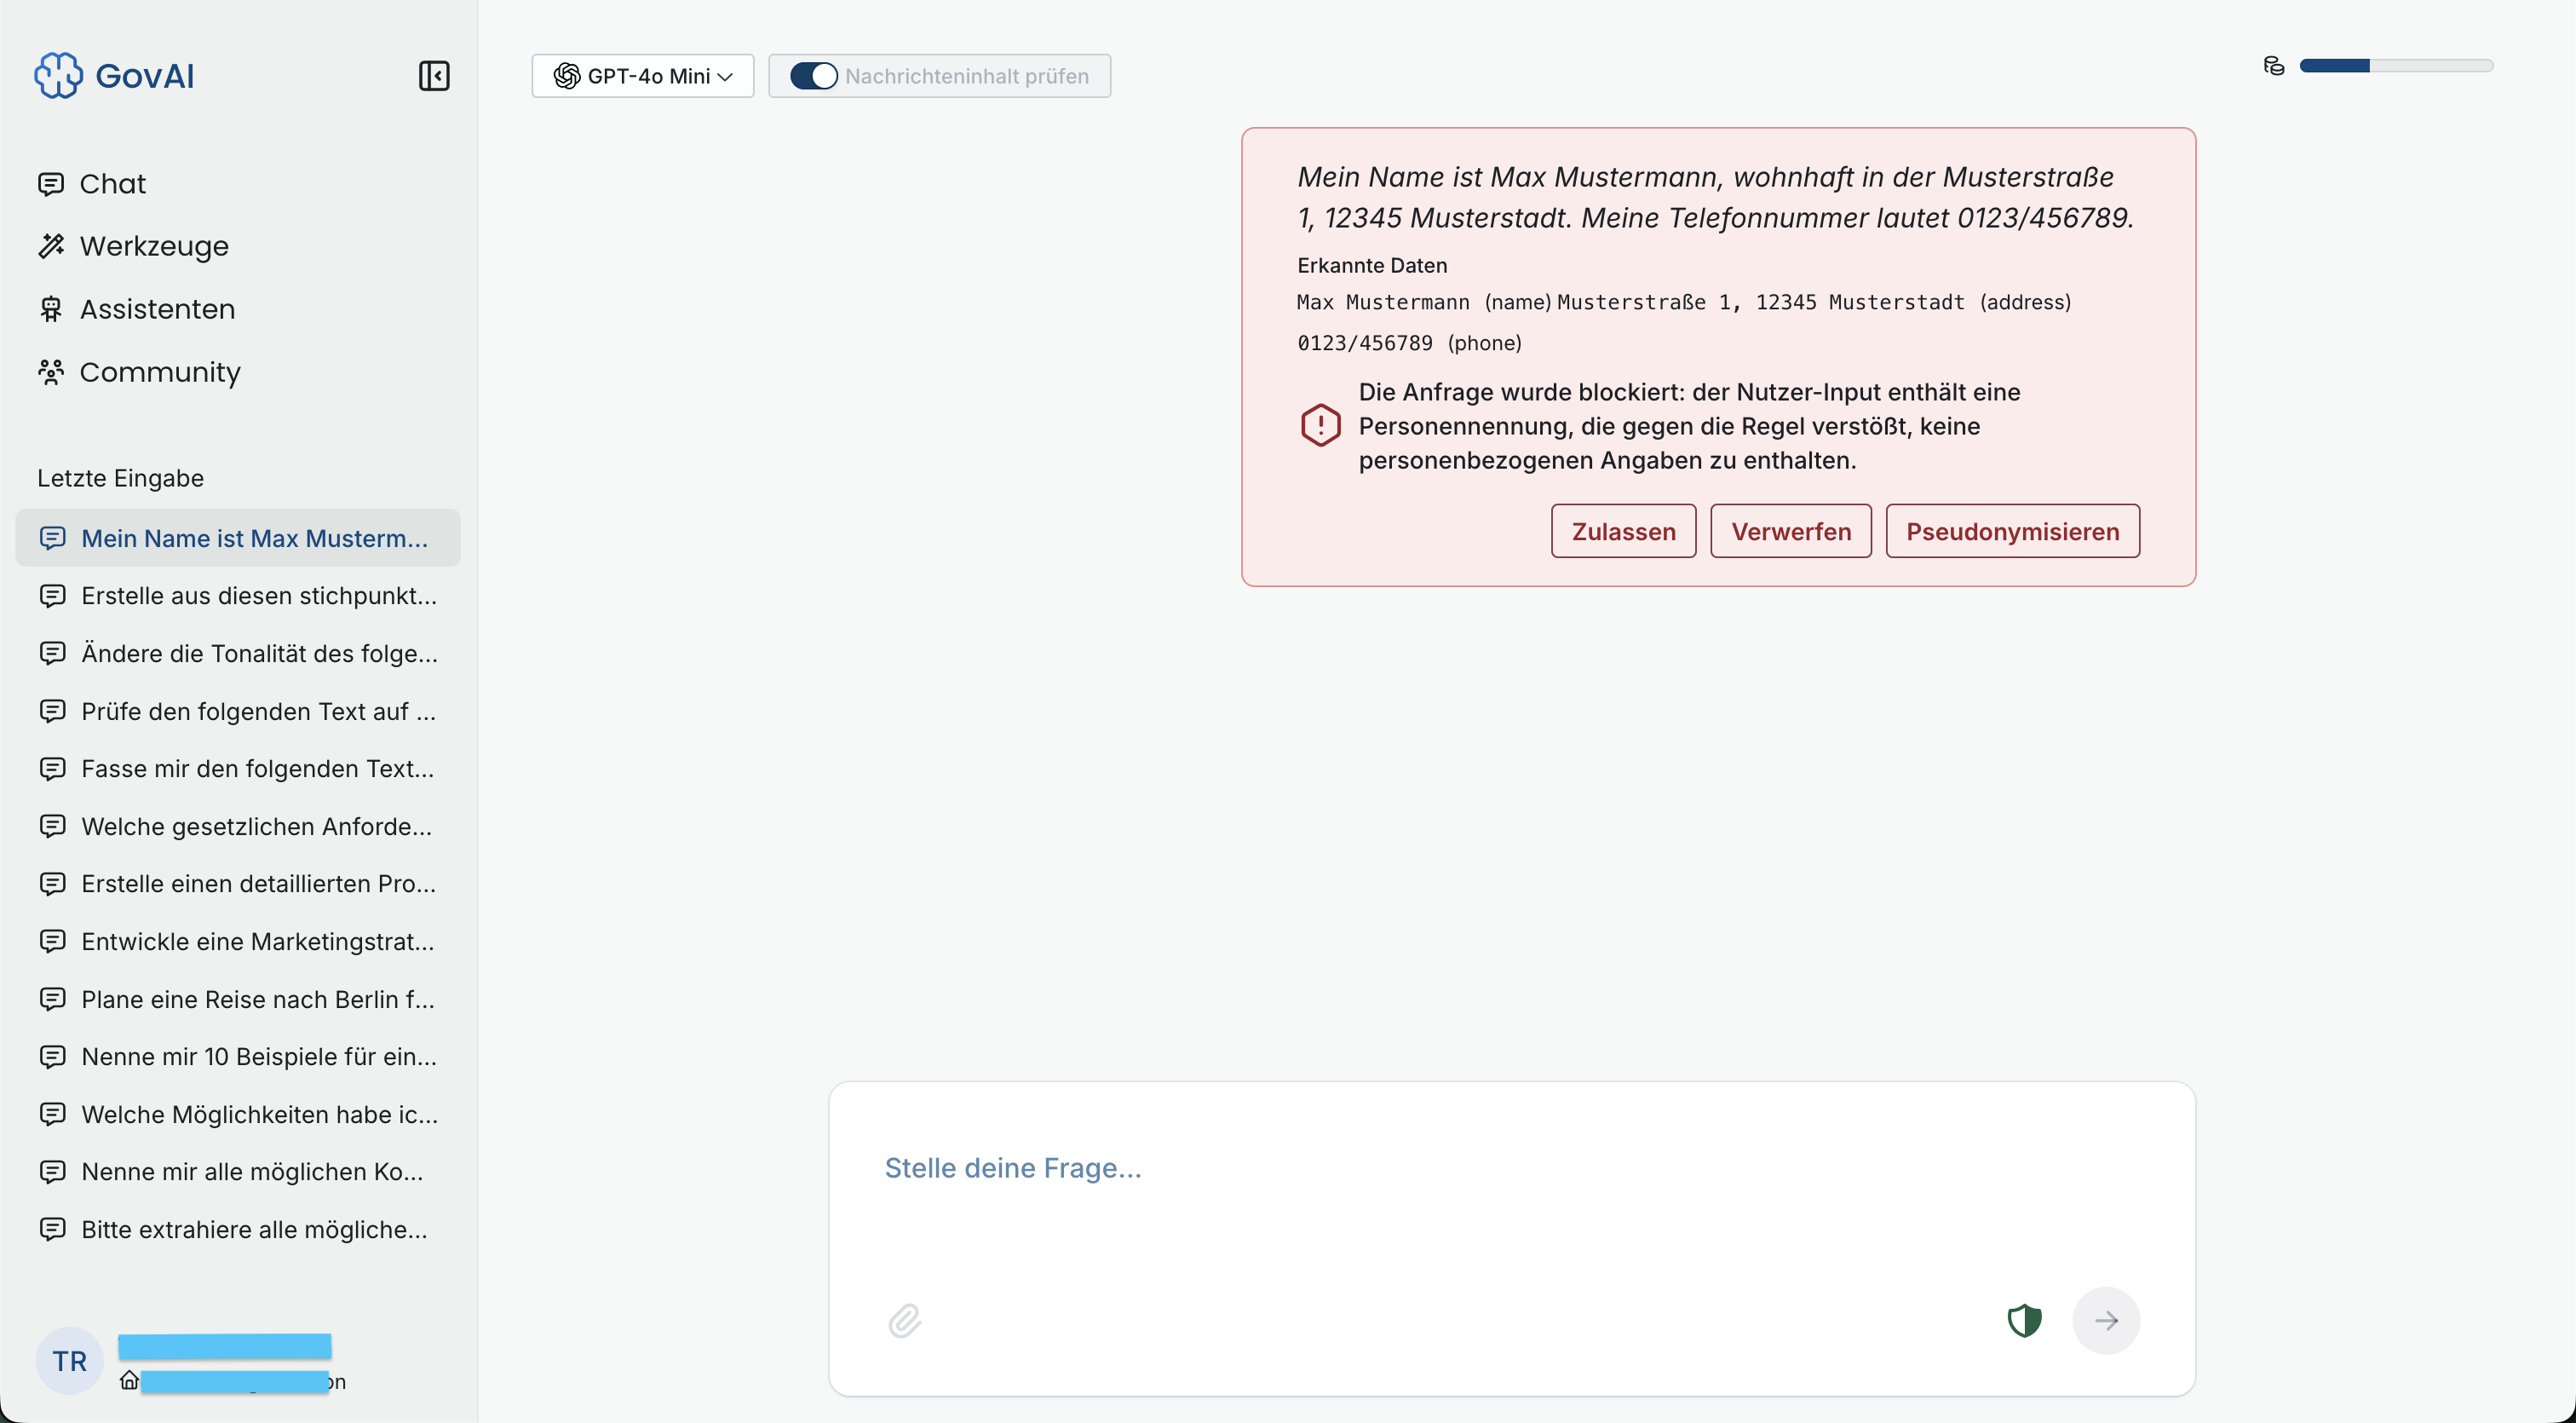
Wenn der Data Guard aktiv ist und sensible Daten erkennt, wird ein Dialog mit drei Optionen angezeigt:
| Option | Beschreibung | Empfohlener Einsatz |
|---|---|---|
| 🔴 Verwerfen | Die Anfrage wird nicht gesendet. Neu formulieren ohne personenbezogene Daten. | Bei versehentlicher Eingabe echter Daten |
| 🟡 Zulassen | Anfrage wird trotz Warnung unverändert gesendet. | Nur für Testdaten (z. B. „Max Mustermann") oder nachweislich freigegebene Inhalte |
| 🟢 Pseudonymisieren | Sensible Daten werden ersetzt, nur pseudonymisierte Anfrage geht ans Modell. Originaldaten erscheinen in der Antwort wieder. | Empfohlen für produktive Nutzung mit sensiblen Inhalten |
Die finale Entscheidung liegt bei Ihnen. Der Data Guard ist ein Hilfsmittel – keine Garantie für vollständige Erkennung. Insbesondere bei unstrukturierten Inhalten, schlechter OCR-Qualität oder ungewöhnlichen Schreibweisen kann es zu Fehlerkennungen (False Negatives) kommen.
5.6 Data Guard-Einstellungen (Konfigurationsmodi)
Für jeden Chat, jedes Werkzeug und jeden Assistenten kann der Data Guard-Modus individuell konfiguriert werden:
| Modus | Beschreibung | Wer entscheidet |
|---|---|---|
| Deaktiviert | Keine PII-Prüfung; Anfrage geht unverändert ans Modell | – |
| Voreingestellt | Standard: Nutzende können den Data Guard selbst aktivieren oder deaktivieren | Nutzende |
| Permanent | Immer aktiv, nicht deaktivierbar; optional erzwungene Pseudonymisierung | System |
Erzwungene Pseudonymisierung (bei Permanent): Wenn konfiguriert, können Nutzende sensible Inhalte nur noch pseudonymisieren oder verwerfen – „Zulassen" ist nicht möglich.
Die Konfiguration erfolgt unter Einstellungen → Feature-Einstellungen → Chats/Werkzeuge/Assistenten (Schnelleinstellungen oder vollständige Konfiguration). Empfehlung für Produktivbetrieb: Permanent mit erzwungener Pseudonymisierung.
5.7 Data Guard bei Datei-Uploads
Der Data Guard greift auch bei Datei-Uploads. Textuelle Inhalte aus Dokumenten und Bildern werden von dem Data Guard auf die selbe Weise geprüft wie Chat-Eingaben.
Für die Option "Text aus Bildern extrahieren" gilt: Bilder werden intern per OCR in Text umgewandelt. Das Originalbild wird nie an ein externes Modell übermittelt – nur der extrahierte Text.
Bilder, welche über die Option "Bilder hochladen" angehangen werden können nicht vom Data Guard geprüft werden. Etwaige Gesichter oder einer Person zuordenbare Merkmale werden nicht geschwärzt oder in sonstiger Weise unkenntlich gemacht. Die Verantwortung für die Prüfung personenbezogener, rein visueller Inhalte liegt bei den Nutzenden. Laden Sie nur Bilder hoch, die für die KI-Verarbeitung freigegeben sind – prüfen Sie im Zweifelsfall mit Ihrer Datenschutzstelle oder IT.
5.8 Nachweis der De-Identifizierung
Für Compliance-Zwecke stellt GovAI folgende Nachweise bereit:
- Architekturdiagramm mit End-to-End-Datenfluss (Original → Pseudonymisiert → Antwort → Re-Kontextualisiert)
- Sequenzdiagramm für den Kernpfad (Request → Redact → Provider → Response → Unredact → UI)
- Testprotokolle mit PII-Korpus (auf Anfrage)
Details: Kap. 12 – Sicherheit & Compliance.